M1519.子树中标签相同的节点数
https://leetcode.cn/problems/number-of-nodes-in-the-sub-tree-with-the-same-label/
给你一棵树(即,一个连通的无环无向图),这棵树由编号从 0 到 n - 1 的 n 个节点组成,且恰好有 n - 1 条 edges 。树的根节点为节点 0 ,树上的每一个节点都有一个标签,也就是字符串 labels 中的一个小写字符(编号为 i 的 节点的标签就是 labels[i] )
边数组 edges 以 edges[i] = [ai, bi] 的形式给出,该格式表示节点 ai 和 bi 之间存在一条边。
返回一个大小为 n 的数组,其中 ans[i] 表示第 i 个节点的子树中与节点 i 标签相同的节点数。
树 T 中的子树是由 T 中的某个节点及其所有后代节点组成的树。
示例 1:

输入:n = 7, edges = [[0,1],[0,2],[1,4],[1,5],[2,3],[2,6]], labels = "abaedcd"
输出:[2,1,1,1,1,1,1]
解释:节点 0 的标签为 'a' ,以 'a' 为根节点的子树中,节点 2 的标签也是 'a' ,因此答案为 2 。注意树中的每个节点都是这棵子树的一部分。
节点 1 的标签为 'b' ,节点 1 的子树包含节点 1、4 和 5,但是节点 4、5 的标签与节点 1 不同,故而答案为 1(即,该节点本身)。
示例 2:

输入:n = 4, edges = [[0,1],[1,2],[0,3]], labels = "bbbb"
输出:[4,2,1,1]
解释:节点 2 的子树中只有节点 2 ,所以答案为 1 。
节点 3 的子树中只有节点 3 ,所以答案为 1 。
节点 1 的子树中包含节点 1 和 2 ,标签都是 'b' ,因此答案为 2 。
节点 0 的子树中包含节点 0、1、2 和 3,标签都是 'b',因此答案为 4 。
示例 3:
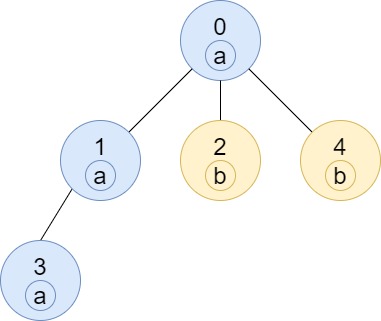
输入:n = 5, edges = [[0,1],[0,2],[1,3],[0,4]], labels = "aabab"
输出:[3,2,1,1,1]
提示:
1 <= n <= 10^5edges.length == n - 1edges[i].length == 20 <= ai, bi < nai != bilabels.length == nlabels仅由小写英文字母组成
这道题可以通过深度优先搜索 (DFS) 自底向上地解决。
解题思路
- 构建邻接表:由于给出的边是无向的,我们需要先建立一个邻接表来表示这棵树。
- 后序遍历 (DFS):
- 树的子树属性往往可以通过自底向上的方式计算。也就是说,一个节点
的子树中某种标签的数量,等于 本身的标签加上它所有子节点 的子树中该标签的数量。 - 我们可以让 DFS 函数返回一个大小为 26 的数组,表示当前子树中每个字母('a' 到 'z')出现的频次。
- 对于每个节点
: - 初始化一个频次数组,将
自身的标签对应的频次设为 1。 - 遍历
的所有子节点 ,递归调用 DFS 获取子节点的频次数组,并将其累加到 的频次数组中。 - 累加完成后,当前节点
对应标签的累加值就是最终答案 ans[u]。 - 将当前节点的频次数组返回给父节点。
- 初始化一个频次数组,将
- 树的子树属性往往可以通过自底向上的方式计算。也就是说,一个节点
注意事项
由于树的深度最大可达 sys.setrecursionlimit 来增加递归深度。
Python 代码实现
python
import sys
from typing import List
from collections import defaultdict

# 增加递归深度以应对深层树结构
sys.setrecursionlimit(200000)

class Solution:
    def countSubTrees(self, n: int, edges: List[List[int]], labels: str) -> List[int]:
        # 1. 构建邻接表
        g = defaultdict(list)
        for u, v in edges:
            g[u].append(v)
            g[v].append(u)

        ans = [0] * n

        # 2. 定义 DFS 函数
        def dfs(node: int, parent: int) -> List[int]:
            # 初始化当前节点的字母计数器(大小为 26)
            counts = [0] * 26
            node_label_idx = ord(labels[node]) - ord('a')
            counts[node_label_idx] = 1

            # 遍历子节点
            for child in g[node]:
                if child != parent:
                    child_counts = dfs(child, node)
                    # 将子树的计数累加到当前节点
                    for i in range(26):
                        counts[i] += child_counts[i]

            # 记录当前节点的答案
            ans[node] = counts[node_label_idx]
            return counts

        # 从根节点 0 开始搜索,父节点设为 -1
        dfs(0, -1)
        return ans
复杂度分析
- 时间复杂度:
。我们对树中的每个节点仅访问一次。在每个节点处,我们需要合并子树的字符频次,由于英文字母只有 26 个,合并操作的时间复杂度为 ,即常数时间。 - 空间复杂度:
。邻接表占用 空间,DFS 递归调用栈在最坏情况下(树退化为链)需要 的空间。每个节点返回的频次数组大小为固定的 26,总辅助空间复杂度也为 。