M28127: 北大夺冠
数据结构, 自定义排序, http://cs101.openjudge.cn/practice/28127/
在刚刚结束的第46届国际大学生程序设计竞赛(简称ICPC),来自全球100多个国家的200多支大学队伍同场竞技。北京大学的三位选手(王展鹏、蒋凌宇、罗煜翔)获得了全球总决赛冠军,这也是北京大学历史最好成绩。
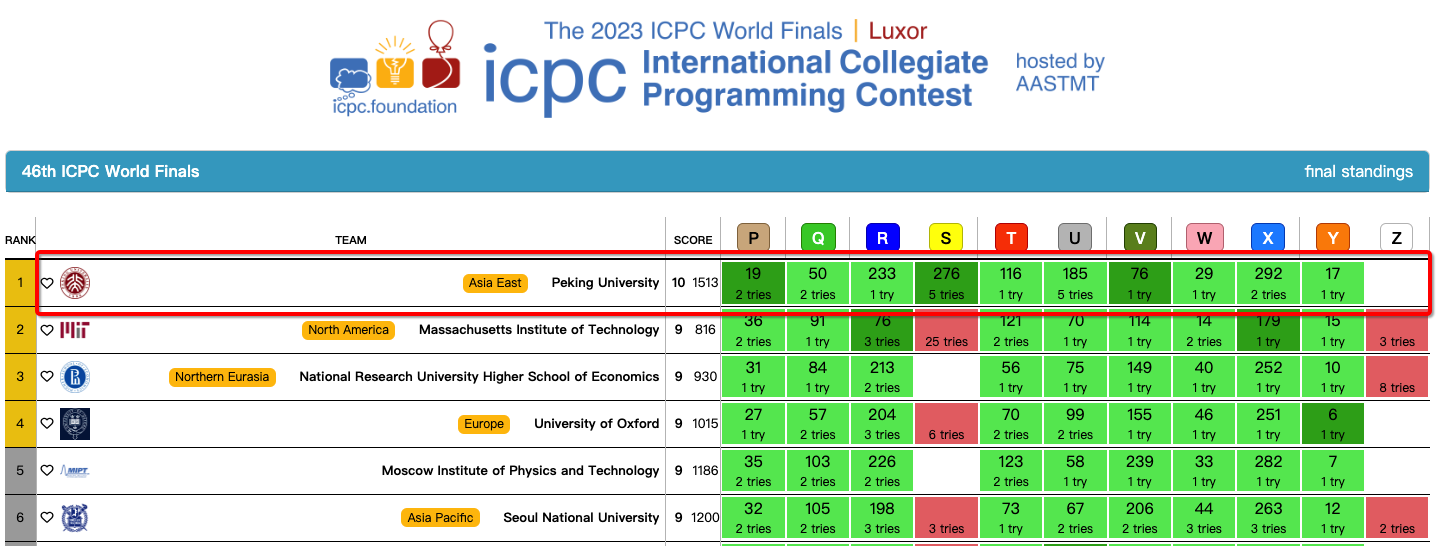
ICPC是全世界最高水平的算法竞赛,各个国家、各个大学最优秀的选手都会参加,比赛采用组队形式,3名选手,共用1台电脑,在5小时内解决10道左右非常困难的算法问题。相比真实比赛的排名规则,本题做了一些简化,请你写个程序计算最终排名。
共有 m 个提交记录,每个提交记录包含队伍名称、提交题目的编号和是否正确(即通过评测)。排序规则为:
- 做对题目多的队伍排名靠前;
- 做对题目数相同时,总提交次数较少的队伍排名靠前;
- 做对题目数和总提交次数都相同时,按队伍名称的字典序排名;
按上述规则输出前 12 名的队伍信息,几点说明和提示:
- 如果队伍总数不足 12 名,则输出所有队伍;
- 如果队伍在某题 AC 后重复提交此题,这时的提交仍然记入总提交数,但重复 AC 同一题不会增加“做对题目数目”;
输入
第一行一个整数 M (1 ≤ M ≤ 1000) 表示提交记录数目。 接下去 M 行,每行一个提交记录,由逗号分隔的三部分组成,第一部分为队伍名称,仅有大小写字母和空格组成;第二部分为题目编号,必为大写字母A-Z之一;第三部分为评测结果,yes 表示通过,no 表示未通过。
输出
共 12 行(队伍总数不足 12 个时,输出全部队伍即可),按排名顺序依次输出每支队伍,包括名次(1开始)、队伍名称、做对题目数(重复AC同一题只计一次)、总提交次数,共四部分信息,信息之间用一个空格隔开。
样例输入
样例输入1
9
Peking University,A,no
Massachusetts Institute of Technology,A,yes
National Research University Higher School of Economics,A,no
University of Oxford,A,yes
Peking University,B,yes
Peking University,A,yes
University of Oxford,C,no
University of Oxford,C,no
National Research University Higher School of Economics,C,yes

样例输入2
31
University of Waterloo,C,yes
University of Waterloo,C,yes
University of Waterloo,C,yes
University of Waterloo,C,yes
University of Waterloo,C,yes
University of Waterloo,D,yes
University of Waterloo,D,no
University of Waterloo,D,yes
University of Waterloo,X,no
University of Waterloo,G,no
University of Waterloo,P,no
Peking University,A,no
Peking University,B,no
Peking University,Y,yes
Peking University,Z,no
Peking University,Y,no
Peking University,Y,yes
Peking University,Y,yes
Peking University,Z,yes
Peking University,A,yes
University of Warsaw,T,no
University of Warsaw,T,yes
University of Warsaw,F,no
University of Warsaw,F,no
University of Warsaw,F,no
University of Warsaw,F,no
University of Warsaw,F,no
University of Warsaw,F,yes
University of Warsaw,Q,no
University of Warsaw,F,no
University of Warsaw,B,no

样例输入3
14
TeamA,A,no
TeamB,B,yes
TeamC,C,no
TeamD,D,yes
TeamE,E,no
TeamF,F,yes
TeamG,G,no
TeamH,H,yes
TeamI,I,no
TeamJ,J,yes
TeamK,K,no
TeamL,L,yes
TeamM,M,no
TeamN,N,yes
样例输出
样例输出1
1 Peking University 2 3
2 Massachusetts Institute of Technology 1 1
3 National Research University Higher School of Economics 1 2
4 University of Oxford 1 3

样例输出2
1 Peking University 3 9
2 University of Warsaw 2 11
3 University of Waterloo 2 11

样例输出3
1 TeamB 1 1
2 TeamD 1 1
3 TeamF 1 1
4 TeamH 1 1
5 TeamJ 1 1
6 TeamL 1 1
7 TeamN 1 1
8 TeamA 0 1
9 TeamC 0 1
10 TeamE 0 1
11 TeamG 0 1
12 TeamI 0 1
来源:张老师和杜老师编程课
解题思路
为了对所有参赛队伍进行正确排名,可以使用一个字典(dict)来存储每支队伍的信息:
- 已解决题目集合(
solved):使用集合(set)来记录某队伍通过(yes)的题目编号。集合可以自动去重,从而方便地统计出该队伍“做对的题目数量”。 - 总提交次数(
subs):一个整数,记录该队伍的所有提交次数(无论通过与否,也无论是否重复)。
在处理完所有的提交记录后,可以将字典转换为列表,并根据以下规则进行多关键字排序:
- 第一关键字:做对题目数(降序)
- 第二关键字:总提交次数(升序)
- 第三关键字:队伍名称的字典序(升序)
最后,输出排名前 12 的队伍信息。如果队伍总数不足 12,则输出所有队伍。
Python 代码实现
import sys

def main():
    # 读取所有输入
    input_data = sys.stdin.read().splitlines()
    if not input_data:
        return

    # 第一行为提交记录数 M
    m = int(input_data[0].strip())

    teams = {}

    for i in range(1, m + 1):
        if i >= len(input_data):
            break
        line = input_data[i].strip()
        if not line:
            continue

        # 解析每行提交数据,去除两端空格
        parts = line.split(',')
        if len(parts) < 3:
            continue
        team_name = parts[0].strip()
        problem = parts[1].strip()
        result = parts[2].strip()

        # 初始化队伍数据
        if team_name not in teams:
            teams[team_name] = {
                'solved': set(),
                'subs': 0
            }

        # 记录提交次数
        teams[team_name]['subs'] += 1

        # 如果通过,则加入已解决题目集合
        if result == 'yes':
            teams[team_name]['solved'].add(problem)

    # 排序规则:
    # 1. 做对题目数降序:-len(x[1]['solved'])
    # 2. 总提交次数升序:x[1]['subs']
    # 3. 队伍名称字典序升序:x[0]
    sorted_teams = sorted(
        teams.items(),
        key=lambda x: (-len(x[1]['solved']), x[1]['subs'], x[0])
    )

    # 输出前 12 名(若不足 12 名,则输出全部)
    limit = min(12, len(sorted_teams))
    for rank in range(1, limit + 1):
        team_name, data = sorted_teams[rank - 1]
        solved_count = len(data['solved'])
        subs_count = data['subs']
        print(f"{rank} {team_name} {solved_count} {subs_count}")

if __name__ == '__main__':
    main()
复杂度分析
时间复杂度:
- 处理
条记录需要 的时间。 - 排序时的队伍数量
。排序的时间复杂度为 。因为字符串比较可能与字符串长度有关,在此处的常数非常小。 - 整体时间复杂度为
,能够高效地在时限内运行完毕。
- 处理
空间复杂度:
- 需要存储所有队伍的名字、已通过题目和提交次数。由于题目和队伍名称长度有限,空间复杂度为
。
- 需要存储所有队伍的名字、已通过题目和提交次数。由于题目和队伍名称长度有限,空间复杂度为
思路:用多个字典存储数据,方便实现同名的添加和修改,排序输出之前再合并到同一个列表里面,这样又变的有利于排序。
# 李云凌 24工学院
from collections import defaultdict

m = int(input())
leaderboard = defaultdict(list)
tries = defaultdict(int)
for _ in range(m):
    team, question, result = input().split(',')
    tries[team] += 1
    if result == 'yes':
        if question not in leaderboard[team]:
            leaderboard[team].append(question)
    else:
        if team not in leaderboard:
            leaderboard[team] = []

ans = []
for key, value in leaderboard.items():
    ans.append((100-len(value), tries[key], key))
ans.sort()
for rank, (correct, tri, team) in enumerate(ans[:12], start=1):
    print(rank, team, 100-correct, tri)
使用 defaultdict 存储每支队伍的提交信息,并根据排序规则进行排名。
import sys
from collections import defaultdict

def process_icpc_results(m, submissions):
    teams = defaultdict(lambda: {'solved': set(), 'attempts': defaultdict(int), 'total_attempts': 0})

    for record in submissions:
        team_name, problem, result = record.split(',')
        team_name = team_name.strip()
        problem = problem.strip()
        result = result.strip()

        teams[team_name]['attempts'][problem] += 1
        teams[team_name]['total_attempts'] += 1

        if result == 'yes':
            teams[team_name]['solved'].add(problem)

    ranking = sorted(
        teams.items(),
        key=lambda item: (-len(item[1]['solved']), item[1]['total_attempts'], item[0])
    )

    for rank, (team_name, data) in enumerate(ranking[:12], start=1):
        print(rank, team_name, len(data['solved']), data['total_attempts'])

if __name__ == "__main__":
    m = int(sys.stdin.readline().strip())
    submissions = [sys.stdin.readline().strip() for _ in range(m)]
    process_icpc_results(m, submissions)
Q: 这是什么意思: teams = defaultdict(lambda: {'solved': set(), 'attempts': defaultdict(int), 'total_attempts': 0})
这行代码使用了
collections.defaultdict来初始化teams这个字典,它的作用是存储每个队伍的提交信息。让我们逐步解析它的结构:pythonteams = defaultdict(lambda: {'solved': set(), 'attempts': defaultdict(int), 'total_attempts': 0})
defaultdict(lambda: {...})
defaultdict是 Python 标准库collections模块中的一种特殊字典,它允许在访问不存在的键时自动创建一个默认值。- 这里
lambda: {...}指定了每个新键的默认值是一个包含多个字段的字典。
- 该字典包含的字段:
'solved': set()
- 这是一个
set(集合),用来存储该队伍成功通过评测(AC,即 "Accepted")的题目。- 由于集合的特性,重复 AC 同一题不会增加题目计数,符合比赛规则。
'attempts': defaultdict(int)
- 这是另一个
defaultdict(int),用来记录该队伍每道题的提交次数。- 例如,
teams["Peking University"]["attempts"]["A"]表示北大队伍对题目 A 的提交次数。
'total_attempts': 0
- 这是一个整数,表示该队伍的总提交次数(无论是否 AC)。
示例:
假设有一条提交记录:
python"Peking University,A,yes"执行
teams["Peking University"]["attempts"]["A"] += 1时:
由于
"Peking University"还不在teams里,defaultdict会自动创建:pythonteams["Peking University"] = {'solved': set(), 'attempts': defaultdict(int), 'total_attempts': 0}然后
"A"题的提交次数增加:pythonteams["Peking University"]["attempts"]["A"] += 1
"A"题通过评测(yes),则加入solved集合:pythonteams["Peking University"]["solved"].add("A")总提交次数
total_attempts增加:pythonteams["Peking University"]["total_attempts"] += 1这样,每个队伍的提交记录都会被自动初始化并正确存储!